KURZ ERKLÄRT
Crawl-Budget wird relevant, wenn große oder häufig veränderte URL-Bestände die rechtzeitige Erfassung wichtiger Seiten behindern. Für eine kleine Beratungswebsite stehen meist andere Probleme im Vordergrund. Prüft zuerst, ob ein tatsächlicher Engpass besteht. Anschließend reduziert ihr unnötige URL-Varianten und verbessert die zuverlässige Auslieferung wichtiger Inhalte.
Wie technische Grundlagen, hilfreiche Inhalte und Sichtbarkeitsmessung zusammenhängen, zeigt der übergeordnete Guide SEO, GEO und AEO für SaaS: Sichtbarkeit, die Kaufentscheidungen unterstützt.
Den Engpass nachweisen
Vergleicht Veröffentlichungszeitpunkte mit ersten beobachteten Abrufen und dem späteren Indexierungsstatus. Nutzt dafür Serverlogs, eure Sitemap und Search Console gemeinsam. Eine Seite, die bereits abgerufen wurde, aber nicht indexiert ist, hat nicht automatisch ein Crawl-Budget-Problem. Trennt Entdeckung, Abruf, Verarbeitung und Auswahl im Index. Erst diese Unterscheidung zeigt, ob ihr an Infrastruktur, interner Verlinkung oder am Inhalt arbeiten müsst. Haltet außerdem fest, welche Seitentypen wirtschaftlich besonders wichtig sind. Mehr dazu im Leitfaden Serverlogs für SEO-Fragen auswerten.
URL-Familien statt einzelne Adressen untersuchen
Gruppiert URLs nach Templates und Parametern: Integrationen, Dokumentation, Ressourcen, Filter, Suche und Kontobereiche. Zählt nicht nur existierende Seiten, sondern auch erzeugbare Kombinationen. Ein Kalender mit beliebig vielen zukünftigen Monaten kann einen praktisch unbegrenzten Raum öffnen. Prüft jede Familie auf einen eigenständigen öffentlichen Nutzen. Dokumentiert für sie den gewünschten Abrufstatus und die verantwortliche technische Komponente. Damit wird aus einer langen Fehlerliste eine überschaubare Architekturentscheidung mit klarer Zuständigkeit. Mehr dazu im Leitfaden Technisches SEO für SaaS-Websites: Was ihr zuerst prüfen solltet.
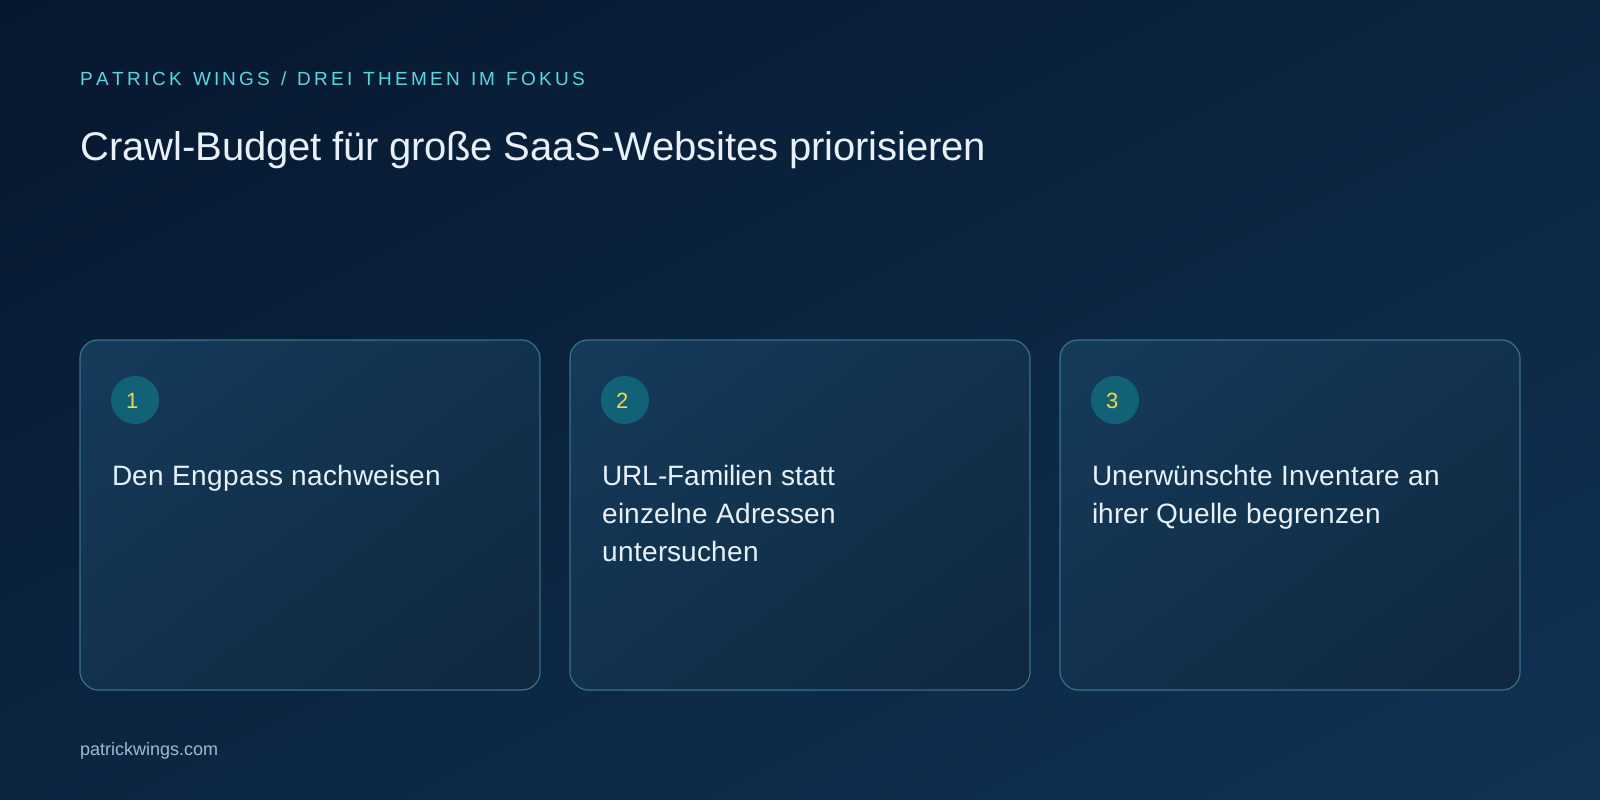
Unerwünschte Inventare an ihrer Quelle begrenzen
Beendet zuerst die unnötige Erzeugung und Verlinkung von Varianten. Vereinheitlicht beispielsweise Parameterreihenfolgen oder entfernt Sitzungsschlüssel aus öffentlichen Links. Canonicals unterstützen die Zusammenführung gleichartiger Inhalte, verhindern aber nicht zuverlässig deren Abruf. Noindex erfordert ebenfalls einen Seitenabruf. Wenn ein kompletter Bereich dauerhaft nicht gecrawlt werden soll, prüft eine passende robots.txt-Regel. Vertrauliche Inhalte gehören unabhängig davon hinter eine echte Zugriffskontrolle. Testet geplante Sperren gegen benötigte Skripte und öffentliche Seiten.
Servergesundheit gezielt überprüfen
Untersucht Antwortzeiten, Fehlerspitzen und Rate-Limits für echte Crawlerzugriffe. Überlastung und wiederholte Serverfehler können die Abrufkapazität begrenzen. Prüft Cacheverhalten und aufwendige Datenbankabfragen auf häufig besuchten Templates. Eine schnellere Anwendung bringt jedoch nicht automatisch mehr Nachfrage nach jedem Dokument. Verbindet Infrastrukturmaßnahmen mit einem konkreten beobachteten Problem. Legt vor Änderungen fest, welche Antwortklassen und welcher Beobachtungszeitraum verglichen werden, damit ein kurzfristiger Lastwechsel nicht als dauerhafte Verbesserung erscheint.

Ein hypothetischer SaaS-Marktplatz
Angenommen, ein fiktiver Integrationsmarktplatz besitzt wertvolle Integrationsprofile, erzeugt aber zusätzlich zahllose Sortier- und Filterkombinationen. Die Logs zeigen überwiegend Abrufe dieser Kombinationen, während neue Profile spät entdeckt werden. Das Team begrenzt die generierten Pfade, verbessert die Verlinkung der Profile und pflegt deren Sitemap. Anschließend prüft es die Abrufverteilung erneut. Dieses Beispiel beschreibt einen möglichen Arbeitsablauf, keine gemessene Kundenwirkung und keine garantierte Indexierungsbeschleunigung nach einer bestimmten Zahl von Tagen.
Messgrößen mit Grenzen lesen
Betrachtet den Anteil nützlicher Abrufe, neue Fehler, die Zeit bis zum ersten Abruf und die Erreichbarkeit aktualisierter Inhalte. Die absolute Zahl der Botbesuche ist kein Erfolgsziel. Weniger Abrufe redundanter Seiten können sinnvoll sein, selbst wenn die Gesamtzahl sinkt. Umgekehrt beweist häufiges Crawling keine gute Sichtbarkeit. Vergleicht ähnliche Zeitfenster und berücksichtigt Produktlaunches, Migrationen und Serverstörungen. Kennzeichnet fehlende Logabdeckung ausdrücklich, etwa wenn das CDN Zugriffe bedient, die im Origin-Log nicht auftauchen.
Eine dauerhafte Inventarrichtlinie etablieren
Definiert für jedes neue Template, ob es öffentlich, crawlbar und für Suchergebnisse vorgesehen ist. Ergänzt Testfälle für leere Filter, ungültige Parameter und sehr tiefe Pfade. Kontrolliert nach größeren Releases eine repräsentative Auswahl erneut. Bewertet das Ergebnis daran, ob wichtige Inhalte zuverlässig erreichbar bleiben und unnötige Pfade begrenzt sind. Vermeidet pauschale Sperren als kurzfristigen Versuch, Abrufe auf andere Seiten umzuleiten. Die Richtlinie soll nachvollziehbare URL-Entscheidungen ermöglichen und regelmäßig an neue Websitefunktionen angepasst werden.
INTERAKTIV / VOM LESEN ZUR ANWENDUNG
Drei Prüfpunkte für eure Umsetzung
Wähle einen Punkt und halte deinen persönlichen Lesefortschritt fest. Die Häkchen werden weder gespeichert noch übertragen und sind keine Bewertung eures Unternehmens.
PRÜFPUNKT 01
Unerwünschte Inventare an ihrer Quelle begrenzen
Beendet zuerst die unnötige Erzeugung und Verlinkung von Varianten.
Im Artikel vertiefen ↗PRÜFPUNKT 02
Servergesundheit gezielt überprüfen
Untersucht Antwortzeiten, Fehlerspitzen und Rate-Limits für echte Crawlerzugriffe.
Im Artikel vertiefen ↗PRÜFPUNKT 03
Ein hypothetischer SaaS-Marktplatz
Angenommen, ein fiktiver Integrationsmarktplatz besitzt wertvolle Integrationsprofile, erzeugt aber zusätzlich zahllose Sortier- und Filterkombinationen.
Im Artikel vertiefen ↗Häufige Fragen
Ist Crawl-Budget für jede SaaS-Website wichtig?
Nein. Prüft zuerst Größe, Änderungsfrequenz und konkrete Verzögerungen.
Spart noindex Abrufe?
Die Anweisung muss zunächst abgerufen werden. Sie ist kein allgemeiner Mechanismus zur Vermeidung von Crawling.
Sind mehr Botbesuche immer besser?
Nein. Entscheidend ist, welche Inhalte zuverlässig erreicht werden.
Wie lässt sich „Den Engpass nachweisen“ praktisch umsetzen?
Vergleicht Veröffentlichungszeitpunkte mit ersten beobachteten Abrufen und dem späteren Indexierungsstatus. Nutzt dafür Serverlogs, eure Sitemap und Search Console gemeinsam. Eine Seite, die bereits abgerufen wurde, aber nicht indexiert ist, hat nicht automatisch ein Crawl-Budget-Problem.
Was ist bei „URL-Familien statt einzelne Adressen untersuchen“ besonders wichtig?
Gruppiert URLs nach Templates und Parametern: Integrationen, Dokumentation, Ressourcen, Filter, Suche und Kontobereiche. Zählt nicht nur existierende Seiten, sondern auch erzeugbare Kombinationen. Ein Kalender mit beliebig vielen zukünftigen Monaten kann einen praktisch unbegrenzten Raum öffnen.