KURZ ERKLÄRT
Mit robots.txt steuert ihr Crawler-Zugriffe, mit noindex beantragt ihr den Ausschluss aus unterstützten Suchindizes und mit Canonical-Angaben kennzeichnet ihr die bevorzugte Version doppelter Inhalte. Entscheidet zuerst, welches Ergebnis eine URL erreichen soll. Prüft anschließend die tatsächlich ausgelieferte Antwort und den später beobachteten Indexierungsstatus.
Wie technische Grundlagen, hilfreiche Inhalte und Sichtbarkeitsmessung zusammenhängen, zeigt der übergeordnete Guide SEO, GEO und AEO für SaaS: Sichtbarkeit, die Kaufentscheidungen unterstützt.
Mit einer Entscheidung je URL beginnen
Erfasst die URL-Familien eurer Anwendung: öffentliche Artikel, Kampagnenvarianten, Kontobereiche, interne Suchergebnisse und herunterladbare Dateien. Notiert jeweils, ob Menschen die Seite erreichen sollen, ob eine Suchmaschine sie abrufen darf und ob sie eigenständig in Suchergebnissen erscheinen soll. Benennt eine verantwortliche Person, die Inhalt und Implementierung versteht. So erhält die Entwicklung einen überprüfbaren Auftrag. Die ungenaue Bitte, eine Seite zu verstecken, kann sonst zu einer Crawling-Sperre führen, obwohl eigentlich Trackingvarianten zusammengeführt oder Kundendaten geschützt werden müssen.
Noindex für den gewünschten Ausschluss einsetzen
Google muss eine Seite abrufen können, um ihre noindex-Anweisung zu entdecken. Eine gleichzeitige Sperre dieser URL in robots.txt kann verhindern, dass die Ausschlussregel gelesen wird. Verwendet einen Eintrag im HTML-Kopf oder einen passenden HTTP-Antwortheader, insbesondere bei Dateien ohne HTML. Prüft beide Stellen, weil eure Infrastruktur zusätzliche Regeln setzen kann. Vertrauliche Inhalte gehören hinter eine Anmeldung. Der Ausschluss aus Suchergebnissen verhindert weder den direkten Zugriff durch Menschen noch den Abruf durch Software, die solche Anweisungen ignoriert.
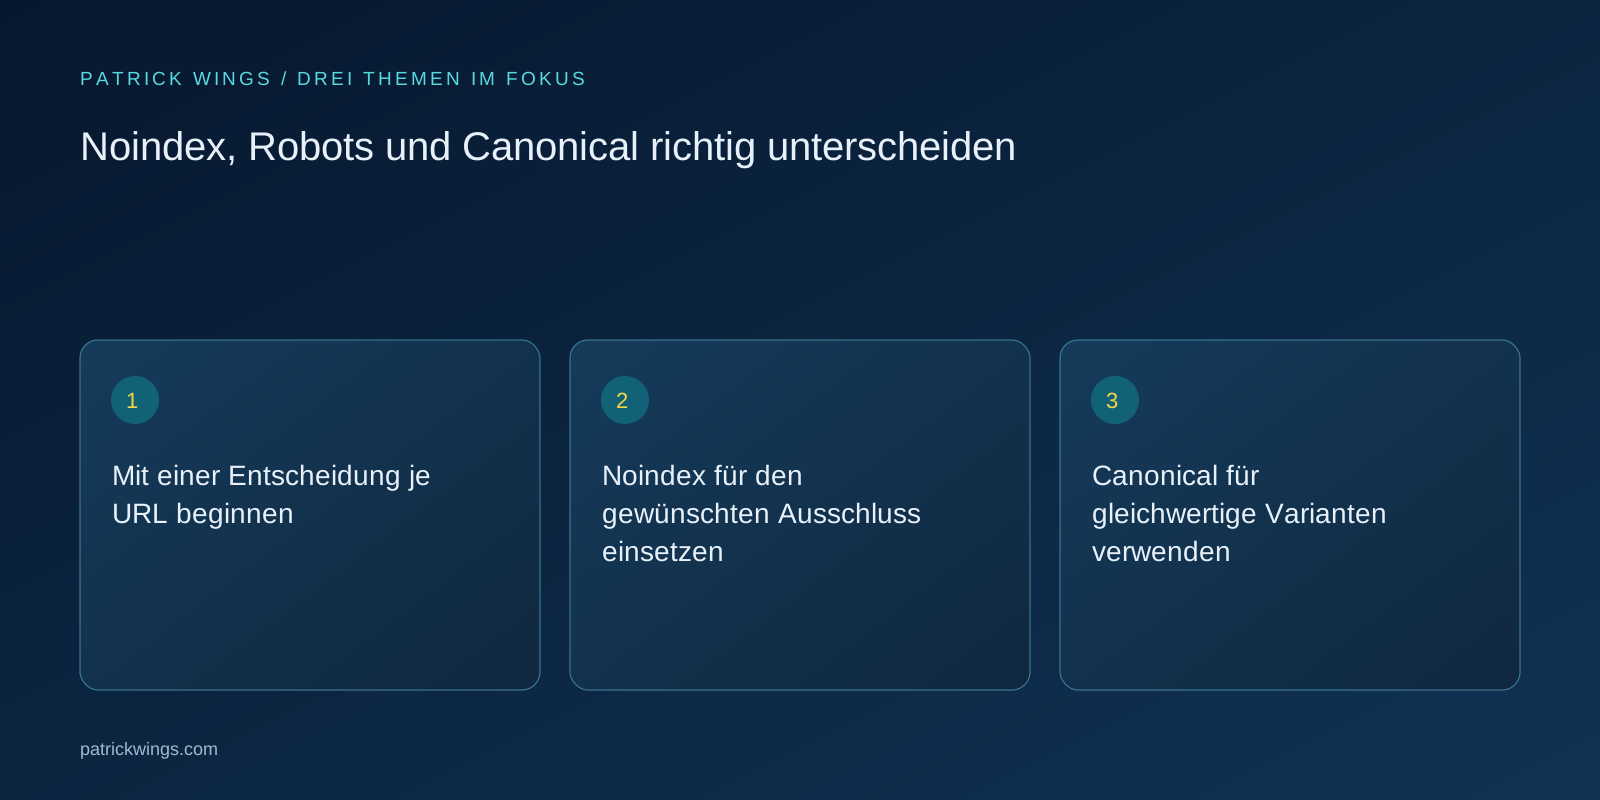
Canonical für gleichwertige Varianten verwenden
Canonical-Angaben benennen eine bevorzugte Repräsentation doppelter oder sehr ähnlicher Seiten. Sie zwingen Suchmaschinen nicht dazu, unterschiedliche Inhalte als gleichwertig zu behandeln. Vergleicht daher Hauptantwort, Zielgruppe und Funktion, bevor ihr URLs zusammenfasst. Interne Links, Sitemap-Einträge und Canonical-Ziele sollten dieselbe Präferenz ausdrücken. Prüft außerdem die erfolgreiche Erreichbarkeit des Ziels. Ändert ein Kampagnenparameter nur die Attribution, kann eine Zusammenführung passen. Erzeugt ein Parameter dagegen andere Informationen oder Angebote, braucht ihr vor einer pauschalen Regel eine inhaltliche Prüfung. Mehr dazu im Leitfaden Canonical-Audits bei SaaS-Websites durchführen.
Eine repräsentative Produktionsstichprobe testen
Wählt Beispiele aller Templates sowie Sonderfälle wie PDFs, paginierte Listen und Sprachvarianten. Dokumentiert Antwortstatus, robots-Zugänglichkeit, Meta-Anweisungen, HTTP-Anweisungen und Canonical-Ziel in einer gemeinsamen Tabelle. Vergleicht ursprüngliche Antwort und gerenderte Seite, wenn JavaScript Metadaten verändert. Wiederholt die Prüfung über das produktive CDN. Ein erfolgreicher lokaler Test zeigt noch nicht, welche Richtlinie öffentliche Besucher und verifizierte Crawler tatsächlich erhalten. Kontrolliert auch den Cache und veröffentlicht nach Änderungen einen dokumentierten Nachtest für jede betroffene Seitenfamilie.
Prüft außerdem, ob mobile Auslieferung, Dateidownloads und alternative Hostnamen dieselben beabsichtigten Regeln zuverlässig übernehmen.

Illustratives Beispiel: eine Webinar-Bibliothek
Stellt euch ein Softwareunternehmen mit einem öffentlichen Webinar-Rückblick, einer Trackingvariante und einem Download mit personenbezogenen Teilnehmerdaten vor. Dieses Beispiel ist ausdrücklich illustrativ und kein gemessenes Kundenergebnis. Der Rückblick bleibt indexierbar; die gleichwertige Trackingvariante verweist per Canonical auf ihn. Der sensible Download erhält eine echte Zugriffskontrolle. Für eine gewöhnliche öffentliche Dankeseite entscheidet das Team gesondert, ob noindex sinnvoll ist. Anschließend prüft es, ob der zuständige Crawler diese Anweisung lesen kann und ob andere Templates unbeabsichtigt betroffen sind.
Ergebnisse mit klaren Grenzen überprüfen
Verbindet nach der Veröffentlichung URL-Prüfung und Indexberichte mit den technischen Auslieferungsdaten. Ein angegebenes Canonical und das von der Suchmaschine gewählte Canonical können voneinander abweichen. Untersucht dann Inhaltsähnlichkeit und widersprüchliche Signale, statt dieselbe URL ständig neu einzureichen. Prüft Richtlinien erneut, wenn Templates, Downloads oder Anmeldung verändert werden. Erfolg bedeutet eine nachvollziehbare Umsetzung des dokumentierten Zwecks und klare Zuständigkeit für Ausnahmen. Indexänderungen benötigen erneutes Crawling und Verarbeitung. Daraus folgt weder eine sofortige Rankingverbesserung noch eine garantierte Aufnahme in KI-Antworten.
INTERAKTIV / VOM LESEN ZUR ANWENDUNG
Drei Prüfpunkte für eure Umsetzung
Wähle einen Punkt und halte deinen persönlichen Lesefortschritt fest. Die Häkchen werden weder gespeichert noch übertragen und sind keine Bewertung eures Unternehmens.
PRÜFPUNKT 01
Canonical für gleichwertige Varianten verwenden
Canonical-Angaben benennen eine bevorzugte Repräsentation doppelter oder sehr ähnlicher Seiten.
Im Artikel vertiefen ↗PRÜFPUNKT 02
Eine repräsentative Produktionsstichprobe testen
Wählt Beispiele aller Templates sowie Sonderfälle wie PDFs, paginierte Listen und Sprachvarianten.
Im Artikel vertiefen ↗PRÜFPUNKT 03
Illustratives Beispiel: eine Webinar-Bibliothek
Stellt euch ein Softwareunternehmen mit einem öffentlichen Webinar-Rückblick, einer Trackingvariante und einem Download mit personenbezogenen Teilnehmerdaten vor.
Im Artikel vertiefen ↗Häufige Fragen
Entfernt robots.txt eine indexierte URL?
Eine Crawling-Sperre ist kein verlässlicher Entfernungsmechanismus. Google kann eine gesperrte URL über Links kennen, ohne ihren Inhalt abzurufen.
Kann ein PDF noindex verwenden?
Ja. Unterstützende Crawler können noindex im HTTP-Antwortheader X-Robots-Tag lesen.
Sollen Übersetzungen auf Englisch kanonisieren?
Echte Sprachversionen sollten normalerweise ein geeignetes Canonical derselben Sprache benennen; Sprachverweise beschreiben die Entsprechungen.
Wie lässt sich „Mit einer Entscheidung je URL beginnen“ praktisch umsetzen?
Erfasst die URL-Familien eurer Anwendung: öffentliche Artikel, Kampagnenvarianten, Kontobereiche, interne Suchergebnisse und herunterladbare Dateien. Notiert jeweils, ob Menschen die Seite erreichen sollen, ob eine Suchmaschine sie abrufen darf und ob sie eigenständig in Suchergebnissen erscheinen soll. Benennt eine verantwortliche Person, die Inhalt und Implementierung versteht.
Was ist bei „Noindex für den gewünschten Ausschluss einsetzen“ besonders wichtig?
Google muss eine Seite abrufen können, um ihre noindex-Anweisung zu entdecken. Eine gleichzeitige Sperre dieser URL in robots.txt kann verhindern, dass die Ausschlussregel gelesen wird. Verwendet einen Eintrag im HTML-Kopf oder einen passenden HTTP-Antwortheader, insbesondere bei Dateien ohne HTML.